Bu sayfada (10)
- §1Yapılandırılmış veri ne yapar, ne yapmaz?
- §2Bozuk JSON-LD: hatalı karakteri bul
- §3Google belgesine uyan Article işaretlemesi
- §4Aynı sayfayı iki kaynak tarif ettiğinde
- §5Organization, Person ve içerik yolu
- §6Blogger ve Next.js
- §7Değişiklikten önce ve sonra test et
- §8Approvalens taraması neye bakıyor?
- §9İşaretlemeni site genelinde kontrol et
- §10Sık sorulan sorular
Yapılandırılmış veri bir siteyi AdSense'ten geçirmiyor, yokluğu da reddettirmiyor. AdSense'in uygunluk sayfasında adı bile geçmiyor. Yine de düzeltmeye değer, çünkü bozuk işaretleme ölü yük. Tek bir fazla virgül içeren JSON-LD bloğu tamamen yok sayılıyor. Tarihi ya da görseli olmayan bir Article öğesi de sayfayı düzgün tarif edemiyor. Hataların çoğu iki yerden geliyor: elle düzenlenmiş JSON ve aynı sayfayı tarif eden iki eklenti. İkisinin de çözümü kısa.
Yapılandırılmış veri ne yapar, ne yapmaz?
Google yapılandırılmış veriyi, bir sayfa hakkında bilgi vermenin ve içeriği sınıflandırmanın standart biçimi olarak tanımlıyor (yapılandırılmış veriye giriş). Çoğu durumda JSON-LD öneriyor. Genel yönergelerdeki üç kural aşağıdaki her şeyi belirliyor:
- Google, işaretleme doğru olsa bile yapılandırılmış verinin arama sonuçlarında görüneceğini garanti etmiyor.
- "Don't mark up content that is not visible to readers of the page." JSON-LD bir yazar adı veriyorsa sayfa da o yazarı göstermeli.
- Zorunlu özellikleri eksik öğeler zengin sonuçlara uygun sayılmıyor. Önerilen özellikler için de ne kadar çok verirsen sonucun o kadar kaliteli olacağı yazıyor.
Google ayrıca az ama eksiksiz ve doğru özelliğin, çok sayıda eksik ya da bozuk özellikten daha önemli olduğunu söylüyor. Bu rehberin özeti de bu: daha az işaretleme, ama düzgün yapılmış.
Bozuk JSON-LD: hatalı karakteri bul
JSON katıdır. Tek bir hata, bloğun tamamını her ayrıştırıcı için okunmaz yapar. Olağan sebepler:
- Değerin içinde tırnak.
"Kazısız" bahçe yatağıgibi bir başlık, kaçış karakteri olmadan şablona girince metin erken biter. - Kıvrık tırnak. JSON'u bir kelime işlemciden geçirince ya da "akıllı tırnak" filtresi çalışınca
"işareti“ ”olur. - Sondaki virgül. Genelde elle yapılan bir düzenlemeden kalan, son özellikten sonraki virgül.
- Yorum satırı.
// ana yazıJavaScript'te geçerli, JSON'da değil. - Tek blokta iki nesne. Köşeli parantez olmadan yan yana iki nesne. Çoğu zaman iki şablon parçasının aynı
<script>içine yazmasından çıkıyor.
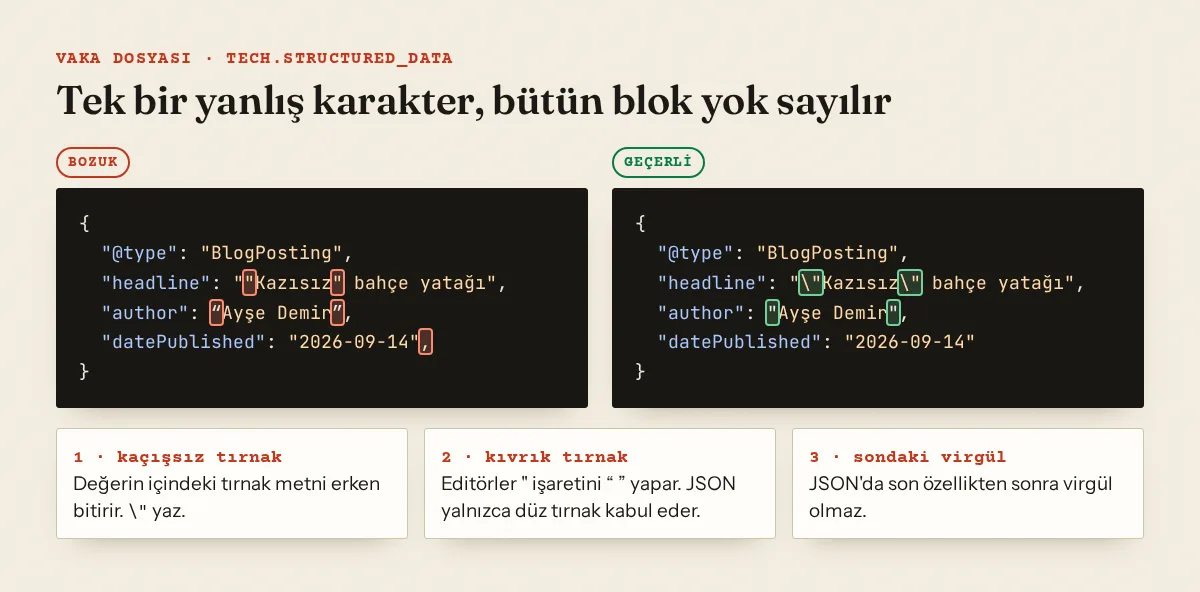
Bloğu ve hatanın yerini bulmak için terminalde şunu çalıştır. Sayfadaki her JSON-LD bloğunu çekip ayrıştırıyor:
$ curl -s https://ornekblog.com/yukseltilmis-yatak/ | python3 -c '
import sys, re, json
html = sys.stdin.read()
for i, raw in enumerate(re.findall(r"<script[^>]*application/ld\+json[^>]*>(.*?)</script>", html, re.S), 1):
    try:
        json.loads(raw); print(i, "ok")
    except ValueError as e:
        print(i, "BROKEN:", e)'
1 ok
2 BROKEN: Expecting property name enclosed in double quotes: line 7 column 1 (char 143)
Satır başında "Expecting property name" hatası neredeyse her zaman bir üst satırda sondaki virgül demek. Search Console kullanıyorsan Unparsable structured data raporu, ciddi bir söz dizimi hatası yüzünden ayrıştırılamayan sayfaları listeliyor. Hata türleri arasında "Parsing error: Missing ',' or '}'" ve "Bad escape sequence in string" var (Search Console Yardım).
Kalıcı çözüm JSON'u elle yazmayı bırakmak. Veriden bir serileştiriciyle üret (PHP'de json_encode, JavaScript'te JSON.stringify) ya da işi tek bir eklentiye bırak.
Google belgesine uyan Article işaretlemesi
Google'ın Article belgesi Article, NewsArticle ve BlogPosting türlerini kapsıyor ve açıkça yazıyor: "There are no required properties; instead, add the properties that apply to your content." Önerilenler author (name ve url ile), dateModified, datePublished, headline ve image. Bir blog yazısı için eksiksiz blok:
<script type="application/ld+json">
{
  "@context": "https://schema.org",
  "@type": "BlogPosting",
  "headline": "Kazısız yükseltilmiş yatak: iki sezonluk deneme",
  "image": ["https://ornekblog.com/img/yatak-16x9.jpg"],
  "datePublished": "2026-09-14T08:00:00+03:00",
  "dateModified": "2026-09-20T10:30:00+03:00",
  "author": [{
    "@type": "Person",
    "name": "Ayşe Demir",
    "url": "https://ornekblog.com/yazarlar/ayse-demir/"
  }]
}
</script>
Görseller için Google 16x9, 4x3 ve 1x1 oranlarında, en az 50.000 piksel (genişlik × yükseklik) olan birkaç yüksek çözünürlüklü sürüm öneriyor. author.url yazarı tanıtan bir sayfaya gitmeli. O sayfada ne olması gerektiği yazar sayfaları ve E-E-A-T rehberinde.
Burada Approvalens Google'dan daha katı ve sebebini bilmelisin. Tarama her Article, BlogPosting ve NewsArticle öğesinde headline, image, datePublished ve author bekliyor. Google bunlara zorunlu değil, önerilen diyor. Biz işaretliyoruz, çünkü tarihi ya da yazarı olmayan bir yazı öğesi yazıyı zayıf tarif ediyor. Article türlerindeki seo.schema_incomplete notunu Google hatası olarak değil, "sayfa bunları gösteriyorsa doldur" diye oku. Yazının öne çıkan görseli yoksa bir tane uydurma. image alanını boş bırak ve notu kabul et.
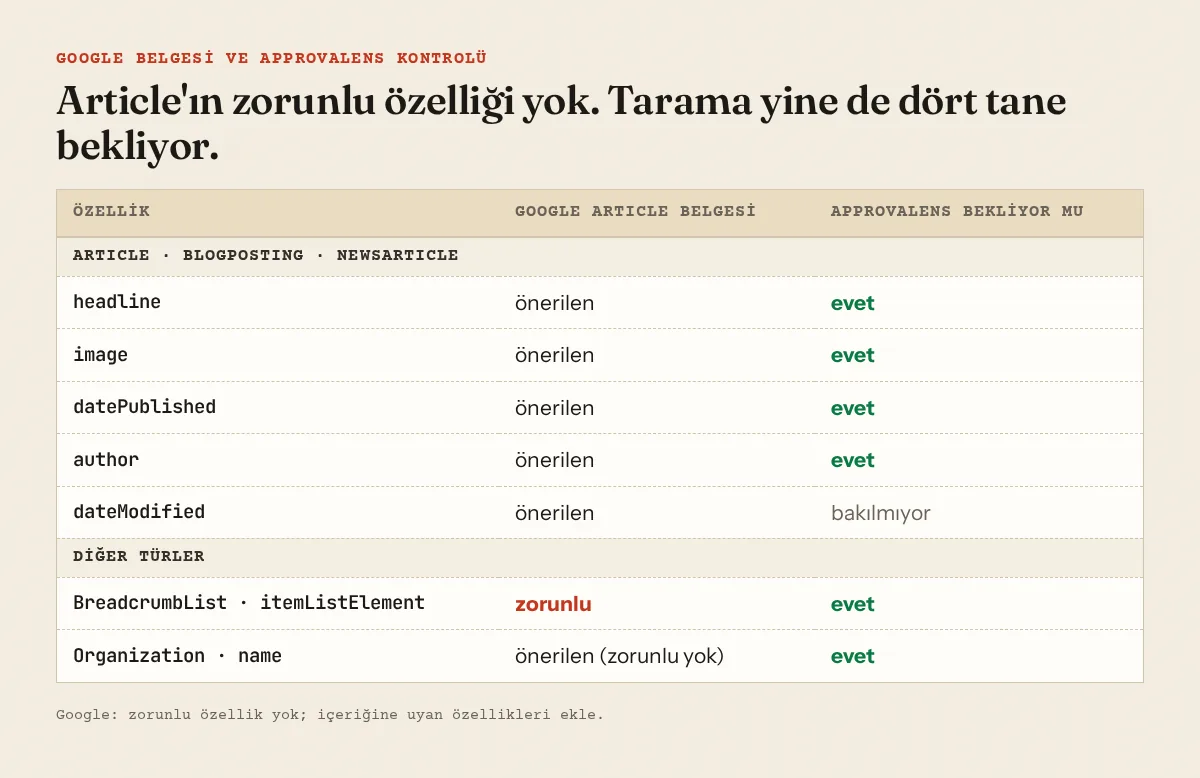
Taradığımız bir sitede rapor 986 eksik öğe listeledi. Ayrıntılar "Article: missing image, datePublished" gibiydi. Bunların bir kısmı ana sayfada ve hiç de yazı olmayan etkileşimli araç sayfalarındaydı. Orada daha iyi çözüm alanları doldurmak değil, uygun bir tür seçmek ya da Article öğesini kaldırmak.
Aynı sayfayı iki kaynak tarif ettiğinde
WordPress sitelerinde çoğu zaman iki şema üreticisi oluyor: temanın kendi işaretlemesi ve SEO eklentisinin grafiği. Bazen de iki SEO eklentisi. Sonuçta bir yazı için iki Article öğesi çıkıyor, çoğunlukla farklı yazarlarla (temadan "admin", eklentiden gerçek ad) ve biri yarı boş.
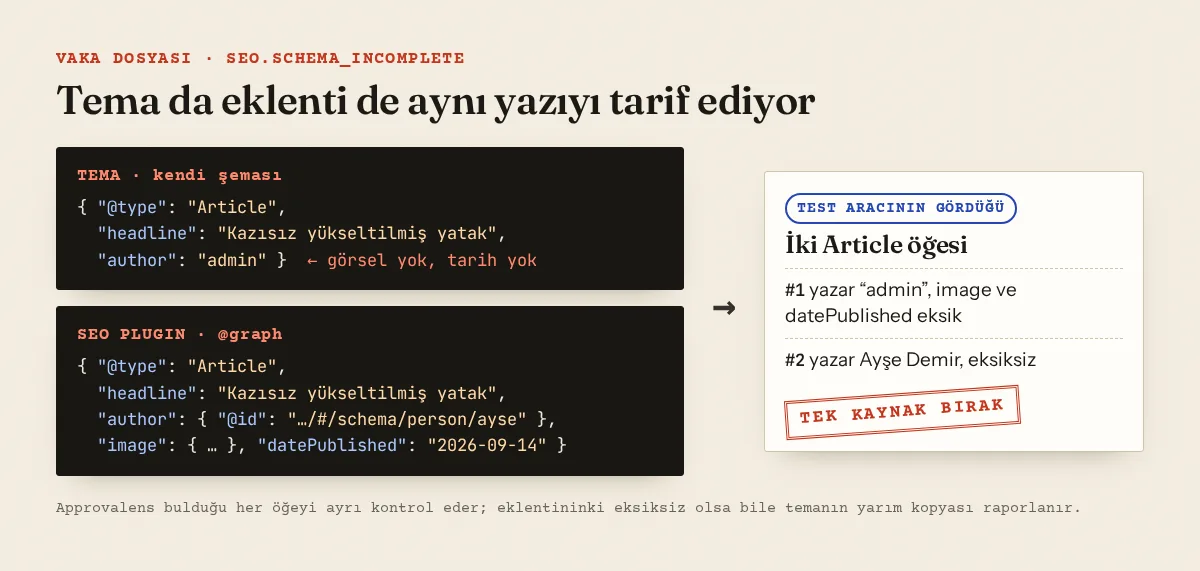
Doğrulamak için sayfa kaynağını aç ve application/ld+json sayısını say. Yoast'un çıktısı <!-- This site is optimized with the Yoast SEO plugin … --> ile <!-- / Yoast SEO … --> arasında duruyor. Rank Math'inki ise <!-- Search Engine Optimization by Rank Math … --> ile <!-- /Rank Math WordPress SEO plugin --> arasında. Bunların dışındaki blok temadan ya da başka bir eklentiden geliyor. Onu kendi ayarlarından kapat ya da ikinci SEO eklentisini devre dışı bırak.
Sonra tuttuğun eklentide varsayılanları ayarla:
- Yoast SEO: Yoast varsayılan olarak sayfalarda WebPage, yazılarda Article şeması kullanıyor. Makale türünü içerik türü bazında Yoast SEO → Settings → Content types altında değiştirebilirsin (Yoast yardım).
- Rank Math: Rank Math SEO → Titles & Meta → Posts altında bir "Schema Type" ayarı var. Article seçince "Article Type" seçeneği çıkıyor (Article, Blog Post ya da News Article) (Rank Math KB).
İki eklenti de image alanını öne çıkan görselden, author alanını WordPress kullanıcısından dolduruyor. Öne çıkan görseli ve gerçek bir görünen adı ayarlarsan eksik öğe notlarının çoğu kaybolur.
Organization, Person ve içerik yolu
trust.org_schema, herhangi bir sayfanın siteyi kimin işlettiğini söyleyip söylemediğine bakıyor. Google'ın Organization belgesi zorunlu özellik olmadığını yazıyor. İşaretlemeyi ana sayfaya ya da kuruluşu anlatan tek bir sayfaya, örneğin hakkımızda sayfasına koymayı öneriyor. Logo en az 112×112 piksel olmalı. Ana sayfa için en sade blok:
{
  "@context": "https://schema.org",
  "@type": "Organization",
  "name": "Örnek Bahçe",
  "url": "https://ornekblog.com/",
  "logo": "https://ornekblog.com/img/logo-512.png",
  "email": "merhaba@ornekblog.com"
}
Tek kişilik bir blog bunun yerine Person kullanmalı. Yoast'ta bu Yoast SEO → Settings → Site representation altında, Organization ya da Person seçerek yapılıyor (Yoast yardım). Rank Math'te Titles & Meta → Local SEO altında. İşaretleme yalnızca Hakkımızda ve İletişim sayfalarının zaten söylemesi gerekeni tekrarlıyor. O sayfalar hakkımızda ve iletişim sayfaları rehberinde.
İçerik yolu (breadcrumb) önce bir gezinme özelliği. Google'ın breadcrumb belgesi itemListElement alanını zorunlu tutuyor. Her ListItem için position, name ve item gerekiyor, yalnızca son öğede item şart değil. Google, URL yapısını kopyalamak yerine tipik bir kullanıcı yolunu yansıtan içerik yolları öneriyor. Yoast'ta açmak için Settings → Advanced → Breadcrumbs yolunu izle, sonra breadcrumb bloğunu, [wpseo_breadcrumb] kısa kodunu ya da tema kodunu ekle (Yoast yardım). Rank Math'te yol Rank Math SEO → General Settings → Breadcrumbs, Schema modülü de açık olmalı (Rank Math KB). İçerik yolunun menüyle nasıl birlikte çalıştığı site menüsü rehberinde.
Blogger ve Next.js
Blogger. Blogger'ın belgelenmiş blog ayarlarında yapılandırılmış veri seçeneği yok. Ne elde edeceğin temana bağlı. Theme menüsünde "My theme" altındaki menüden Edit HTML'i seç ve neler olduğunu görmek için application/ld+json ara. Kendin blok ekleyeceksen sabit tut (kuruluş ya da kişi adı, adres, logo) ve yalnızca ana sayfaya ekle. Tema dosyası XML olduğu için bir değerdeki çıplak & kaydetmeyi engelleyebilir. Yerine "ve" yaz. Her değişiklikten sonra canlı sayfayı test et.
Next.js. Next.js 16 belgeleri JSON-LD'yi layout.js ya da page.js bileşenlerinde bir <script> etiketi olarak basmayı ve < karakterini kaçışlamayı öneriyor (belgelerdeki json-ld.md):
// app/blog/[slug]/page.tsx
export default async function Page({ params }: { params: Promise<{ slug: string }> }) {
  const { slug } = await params
  const post = await getPost(slug)
  const jsonLd = {
    '@context': 'https://schema.org',
    '@type': 'BlogPosting',
    headline: post.title,
    image: post.coverUrl ? [post.coverUrl] : undefined,
    datePublished: post.publishedAt,
    dateModified: post.updatedAt,
    author: [{ '@type': 'Person', name: post.author.name, url: post.author.url }],
  }
  return (
    <article>
      <script
        type="application/ld+json"
        dangerouslySetInnerHTML={{ __html: JSON.stringify(jsonLd).replace(/</g, '\\u003c') }}
      />
      <h1>{post.title}</h1>
    </article>
  )
}
JSON.stringify sondaki virgül ya da kaçışsız tırnak üretemez, bu yüzden bu yol tech.structured_data bulgusuna yol açmaz. Ama undefined değerleri sessizce atar. Kapak görseli olmayan bir yazıda image hiç olmaz. Bu dürüst bir sonuç, ama eksik öğe olarak görünür. next/script değil, düz <script> kullan. Belgeler JSON-LD'nin çalıştırılabilir kod değil, yapılandırılmış veri olduğunu hatırlatıyor. Site geneli Organization işaretlemesini kök layout'a, Article işaretlemesini yazı sayfasına koy ki ikisi çakışmasın.
Değişiklikten önce ve sonra test et
- Zengin Sonuçlar Testi: Canlı bir adresi test et ya da kod yapıştır, akıllı telefon veya masaüstü tarayıcısını seç (Search Console Yardım). Yalnızca Google'ın zengin sonuçlarda kullandığı türleri raporluyor.
- Schema Markup Validator: Google'ın kullanmadığı türler dahil her schema.org işaretlemesini kontrol ediyor. Next.js belgeleri de iki aracı birlikte gösteriyor.
- Search Console: Unparsable structured data raporu ve URL Denetimi aracı, Google'ın canlı sayfadan ne okuduğunu gösteriyor. Düzelttikten sonra rapordaki "Validate Fix" düğmesini kullan.
Approvalens taraması neye bakıyor?
Tarama, sunucunun gönderdiği HTML'deki <script type="application/ld+json"> bloklarını okuyor. Microdata ya da RDFa okumuyor, @graph içine de bakıyor. Tarama ve sayfa türleri metodoloji sayfasında.
| Bulgu | Ne zaman çıkar | Düzey |
|---|---|---|
tech.structured_data |
Taranan herhangi bir sayfadaki bir JSON-LD bloğu JSON olarak ayrıştırılamıyor. Boş bloklar atlanıyor. | bilgi notu |
seo.schema_incomplete |
Ana sayfadaki ya da bir yazıdaki bir öğede listemizdeki bir özellik eksik: Article/BlogPosting/NewsArticle için headline, image, datePublished, author; Organization için name; BreadcrumbList için itemListElement; ayrıca Recipe, Product, FAQPage, HowTo, VideoObject, Event, LocalBusiness ve Review için ayrı listeler |
bilgi notu, 5+ öğede uyarı |
trust.org_schema |
Taranan hiçbir sayfada Organization, Person, WebSite, NewsMediaOrganization, LocalBusiness ya da Corporation öğesi yok | bilgi notu |
structure.breadcrumbs |
5+ yazı varken yazıların %30'undan azında BreadcrumbList işaretlemesi ya da görünür bir içerik yolu öğesi (sınıfında "breadcrumb" geçen ya da öyle etiketlenmiş bir nav) var | bilgi notu |
İşaretlemesi olmayan görünür bir içerik yolu bu kontrolden geçiyor. Görünür içerik yolu olmadan yalnızca işaretleme de geçiyor, ama Google'ın yönergeleri işaretlediğin şeyin sayfada olmasını bekliyor.
İşaretlemeni site genelinde kontrol et
Ücretsiz Approvalens taraması bozuk JSON-LD içeren sayfaları ve eksik öğeleri, her birinde eksik olan özelliklerle birlikte listeliyor. Böylece sorunun bir eklenti ayarı mı yoksa tek seferlik bir şablon hatası mı olduğunu görürsün.
Sık sorulan sorular
AdSense onayı için yapılandırılmış veri gerekir mi?
Hayır. AdSense'in uygunluk şartlarında geçmiyor. Google'ın sayfaları anlamasına ve zengin sonuçlara uygun hale gelmesine yardım edebilir, ama onay içeriğe ve politikalara uyuma bağlı.
Zengin Sonuçlar Testi yeterli mi?
Google'ın zengin sonuç türleri için evet. Diğer schema.org türleri için ya da sayfadaki her şeyi görmek için Schema Markup Validator'ı da kullan.
Tamamlayamadığım işaretlemeyi kaldırmalı mıyım?
Tür sayfaya uymuyorsa evet. Article olarak işaretlenmiş bir ana sayfa ya da araç sayfası kimsenin işine yaramaz. Tür uyuyor ama görsel gibi bir değer eksikse, uydurmak yerine o özelliği hiç yazmamak daha iyi.
İki eklenti şema basıyor. Hangisini tutayım?
Başlık ve açıklamaları da yöneten eklentiyi tut, <head> tek bir eklentinin olsun. Temada ve diğer eklentilerde şema çıktısını kapat. Aynı çakışma çoğu zaman çift title etiketine de yol açıyor, o konu kopya başlık ve meta açıklama rehberinde.
Yapılandırılmış veriyi düzeltmek sıralamayı değiştirir mi?
Google'ın yapılandırılmış veri belgeleri sıralamayla ilgili bir iddiada bulunmuyor. Zengin sonuçlara uygunluktan söz ediyor ve onu da garanti etmiyor.
Eskimiş ya da yanlış bir şey mi gördün? Bize yaz, düzeltelim.
Bu rehberi İngilizce oku →Ücretsiz tarama
Kendi siteni kontrol et
Ücretsiz tarama: uygunluk puanı ve tüm sorunlar, genelde birkaç dakikada.