Google'da görünmesini istediğin bir sayfada noindex varsa, Google sayfayı bir sonraki taramada sonuçlardan çıkarır. Bu kural iki yerde durabilir: HTML'deki robots <meta> etiketinde ya da sayfa kaynağında hiç görmediğin X-Robots-Tag HTTP başlığında. Kazara olanların çoğu geliştirme döneminden kalan bir ayardır: WordPress'teki "Discourage search engines" kutusu, bir SEO eklentisinin varsayılanı, staging ortam değişkeni ya da sunucu kuralı. Hangisinin konuştuğunu bul, kaynağında kapat, sonra Google'dan yeniden taramasını iste.
Noindex demenin iki yolu
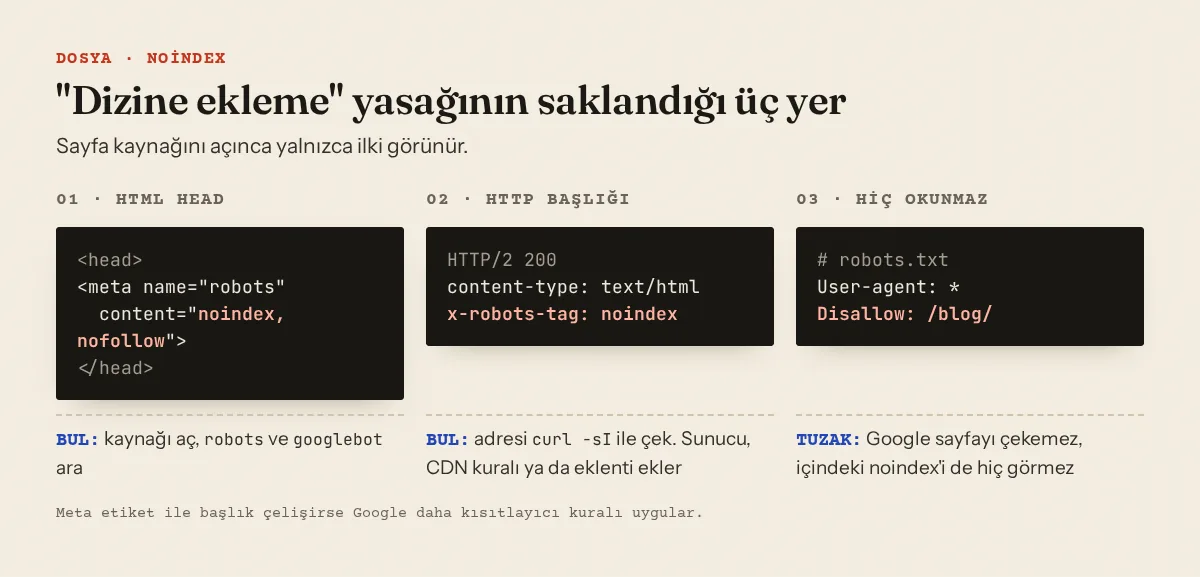
Google'ın robots meta etiketi belgesi ikisini de anlatıyor: sayfanın içindeki bir etiket ya da belirli bir adresin HTTP yanıtına eklenen bir başlık. İkisi aynı işi yapar:
<meta name="robots" content="noindex, nofollow">
<meta name="googlebot" content="noindex">
HTTP/2 200
content-type: text/html; charset=UTF-8
x-robots-tag: noindex
Kafa karışıklığının çoğu iki ayrıntıdan çıkıyor. content="none" kısaltmadır; Google'a göre noindex, nofollow ile aynı anlama gelir. Kurallar çelişirse daha kısıtlayıcı olan uygulanır ("the more restrictive rule applies"). Meta etiketinde index, follow, başlığında noindex olan sayfa noindex sayfadır. Yani meta etiketin kusursuz olsa bile sayfa gizli kalabilir.
Beş dakikada bul
1. HTML. Sayfayı aç, kaynağı görüntüle (Ctrl+U), önce robots sonra googlebot ara. Tema, SEO eklentisi ve bir üyelik ya da çerez eklentisi ayrı ayrı etiket basabilir; birden fazla etiket var mı diye bak.
2. Başlıklar. Başlık HTML'de görünmez, sunucuya doğrudan sor:
curl -s -D - -o /dev/null https://ornekblog.com/kahve-ogutme-ayari | grep -i robots
x-robots-tag: noindex, nofollow
Bu komut normal bir GET isteği gönderip yalnızca başlıkları yazdırır. curl -sI HEAD isteği gönderir ve bazı sunucular HEAD'e farklı cevap verir. Başlık kuralları çoğu zaman bir klasöre ya da dosya türüne yazılır; yalnızca ana sayfayı değil bir yazıyı da dene.
3. Google ne gördü? Search Console'daki URL Denetimi aracında "Indexing allowed?" alanı, sayfanın dizine eklemeyi açıkça yasaklayıp yasaklamadığını ve yasaklıyorsa nedenini gösterir (URL Denetimi yardımı). "Test live URL" son taramayı değil sayfanın şu anki hâlini kontrol eder; düzeltmeden hemen sonra işine yarayan bu. Sayfa dizine ekleme raporu etkilenen adresleri "URL marked 'noindex'" başlığı altında toplar (rapor yardımı). Arayüzü Türkçe kullanıyorsan etiketler çevrilmiş görünür.
4. Bot ne alıyor? Bazı güvenlik eklentileri ve CDN'ler botlara farklı cevap verir. Googlebot erişim kontrolü ana sayfanı tarayıcı, telefon, Googlebot, Mediapartners-Google ve AdsBot olarak çeker; her biri için durum kodunu, son adresi ve kelime sayısını gösterir. Googlebot 403 ya da 5xx alıyorsa sorun noindex değil, erişim sorunu. Bir doğrulama sayfası görüyorsa büyük ihtimalle Cloudflare devrede.
robots.txt tuzağı
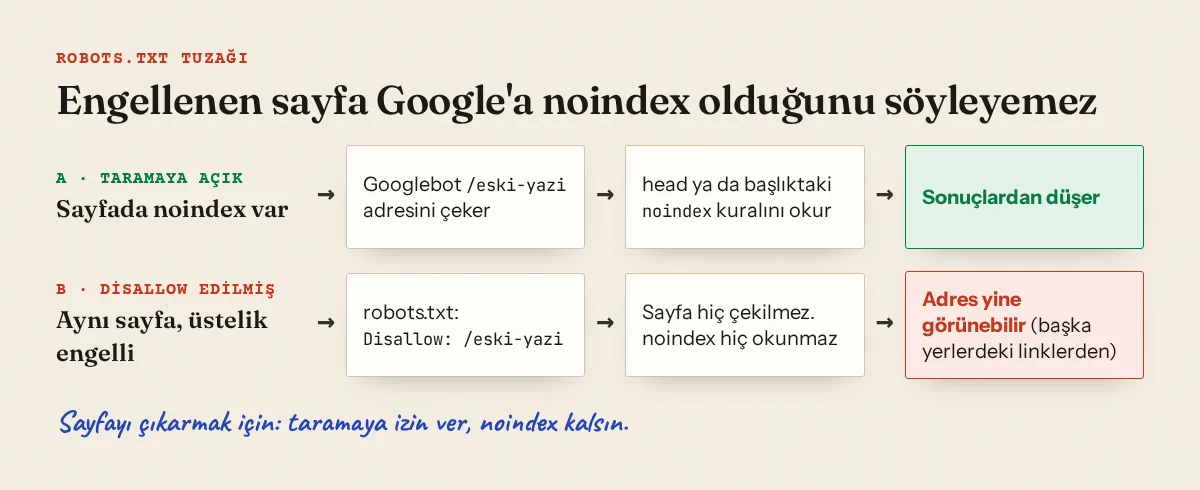
Noindex sorununu fark edince "bir de robots.txt'den engelleyeyim" refleksi yaygın. Bu, noindex'i bozar. Google dizine eklemeyi engelleme sayfasında açık konuşuyor: sayfa robots.txt ile engellenmişse ya da tarayıcı sayfaya erişemiyorsa "the crawler will never see the noindex rule", yani kuralı hiç görmez ve sayfa sonuçlarda yine görünebilir.
Tuzak ters yönde de çalışır. Gereksiz noindex'i kaldırdın ama adres hâlâ Disallow ise Google değişikliği görmek için sayfayı çekemez. Dizine ekleme isteği göndermeden önce yolu robots.txt test aracında dene. Grup eşleşmesi ve Mediapartners-Google'ın neyi okuduğu robots.txt rehberinde.
İstenmeyen noindex nereden gelir?
| Kaynak | Ne basar | Nerede kapatılır |
|---|---|---|
| WordPress "Discourage search engines from indexing this site" | WordPress 5.3'ten beri noindex,nofollow içeren robots meta etiketi (Reading ayarları) |
Settings → Reading → "Search engine visibility" (Türkçe panelde Ayarlar → Okuma) |
| Yoast SEO, tek yazı | Meta robots noindex | Advanced sekmesi → "Allow search engines to show this content in search results" → No (Yoast) |
| Yoast SEO, bütün bir içerik türü | O türdeki her sayfada noindex | Yoast SEO → Settings → Content types → "Show [tür] in search results" |
| Rank Math, tek yazı ya da tür | Meta robots noindex | Advanced sekmesi → Robots Meta ya da Rank Math SEO → Titles & Meta → örneğin "Post Robots Meta" (Rank Math) |
| Blogger | Blog geneli ya da yazı bazında robots meta | Ayarlar → "Crawlers and indexing" → "Enable custom robots header tags"; yazı düzenleyicide "Custom robots tags" (Blogger Yardım) |
| Next.js | metadata / generateMetadata içindeki robots |
Layout ya da sayfa dosyaları, çoğu zaman bir ortam değişkeninin arkasında |
| Apache, Nginx, CDN | X-Robots-Tag başlığı |
.htaccess, sunucu yapılandırması, yanıt başlığı kuralları |
Rank Math'e göre yazının kendi ayarı Titles & Meta varsayılanını ezer. Tür düzeyindeki ayarı düzelttikten sonra etkilenen bir yazıyı ayrıca kontrol et; eski noindex orada kalmış olabilir.
Blogger
Unutulan iki anahtar var. Ayarlar → "Privacy" altında "Visible to search engines" açık olmalı. "Crawlers and indexing" altında "Enable custom robots header tags" açılınca üç grup çıkar: "Home page tags", "Archive and search page tags" ve "Post and page tags". Son grupta işaretlenmiş bir noindex bütün yazıları tek hamlede gizler. Ayrıca her yazının düzenleyicisinde kendi "Custom robots tags" paneli var; tek tek yazılara da bak.
Next.js
App Router'da robots kuralları metadata içindeki robots alanından gelir (generateMetadata belgesi). Segmentler sığ birleştirilir: sayfadaki robots nesnesi layout'takinin üstüne eklenmez, onu tamamen değiştirir. Klasik sızıntı şuna benzer bir staging anahtarıdır; production sunucusunda SITE_ENV tanımlı değilse bütün site noindex olur:
// app/layout.tsx: açıkça production değilse noindex
export const metadata: Metadata = {
  robots: process.env.SITE_ENV === 'production'
    ? { index: true, follow: true }
    : { index: false, follow: false },
}
Bir Next.js durumu daha: akış (streaming) başladıktan sonra notFound() çağrılırsa durum kodu zaten 200 olarak gitmiştir; Next.js belgesine göre bu durumda akan HTML'e <meta name="robots" content="noindex"> eklenir. Suspense içinde veri çekerken ara sıra hata alan bir yazı, Google'a noindex'li bir 200 sayfası olarak ulaşabilir.
Sunucu ve CDN başlıkları
Başlığı ekleyebilecek yerlerde ara:
grep -Rni "x-robots-tag" .htaccess /etc/apache2/ /etc/nginx/ 2>/dev/null
Apache'de satır genelde Header set X-Robots-Tag "noindex, nofollow" şeklindedir; sil ya da yalnızca kastettiğin dosyalara uyan bir koşulun içine al. Nginx'te server bloğundaki add_header X-Robots-Tag "noindex";, kendi add_header satırı olmayan her location için geçerlidir; belgeye göre bu yönergeler yalnızca mevcut seviyede hiç add_header yoksa üst seviyeden miras alınır (nginx belgesi). Cloudflare'de Rules → Overview altındaki yanıt başlığı kurallarına bak; bir "Response Header Transform Rule" başlığı her yanıta ekleyebilir (Cloudflare belgesi).
Staging sızıntıları ve "bozuk" görünen önizlemeler
Staging doğru biçimde gizlenmişti, sonra bir veritabanı kopyası, bir yapılandırma dosyası ya da ortam değişkeni canlıya taşındı. Staging'den klonlanan WordPress veritabanı "Discourage" ayarını da taşır; olduğu gibi kopyalanan .htaccess başlık kuralını da.
Tersi de yanıltır. Vercel her önizleme dağıtımına otomatik olarak X-Robots-Tag: noindex başlığı ekliyor (Vercel); Cloudflare Pages'te de varsayılan olarak her önizleme dağıtımı bu başlığı taşıyor (Cloudflare). curl testin bir önizleme adresine gidiyorsa gördüğün noindex beklenen davranış. Canlı alan adını test et.
Noindex ne zaman doğru tercih?
Tarama ters yönde de çalışıyor: structure.index_bloat, dizine açık duran zayıf sayfaları listeler. Google etiket sayfalarının noindex olması gerektiğine dair bir kural yayımlamıyor; aşağıdaki tablo bizim önerimiz, zorunluluk değil.
| Sayfa türü | Önerimiz |
|---|---|
| Yazılar, rehberler, ana sayfa, hakkımızda, iletişim | Dizine açık |
| Yazılı bir girişi olan kategori sayfası | Dizine açık |
| Sadece link listesinden ibaret etiket ya da arşiv sayfası | Noindex ya da gerçek bir giriş yazısı |
Site içi arama sonuçları (?s=, /search/, /arama/) |
Noindex |
| Giriş, sepet, ödeme, hesap, teşekkürler sayfaları | Noindex |
| Bir listenin 2., 3., 4. sayfası | İsteğe bağlı, aşağıya bak |
Sayfalamada dikkatli ol. Google'ın sayfalama rehberi dizinin ilk sayfasını canonical yapmamanı, her sayfaya kendi canonical adresini vermeni söylüyor ("give each page its own canonical URL"). Sonraki sayfaları noindex yapmanı istemiyor. Ne seçersen seç, bu sayfalardaki linkler taranabilir kalsın ki eski yazılara ulaşılabilsin. Gizlemek yerine geliştirilmesi gereken sayfalar için zayıf içerik rehberine bak.
Approvalens neye bakıyor?
Tarama, taradığı her sayfanın robots ve googlebot meta etiketlerini ve X-Robots-Tag başlığını okur. Sonra:
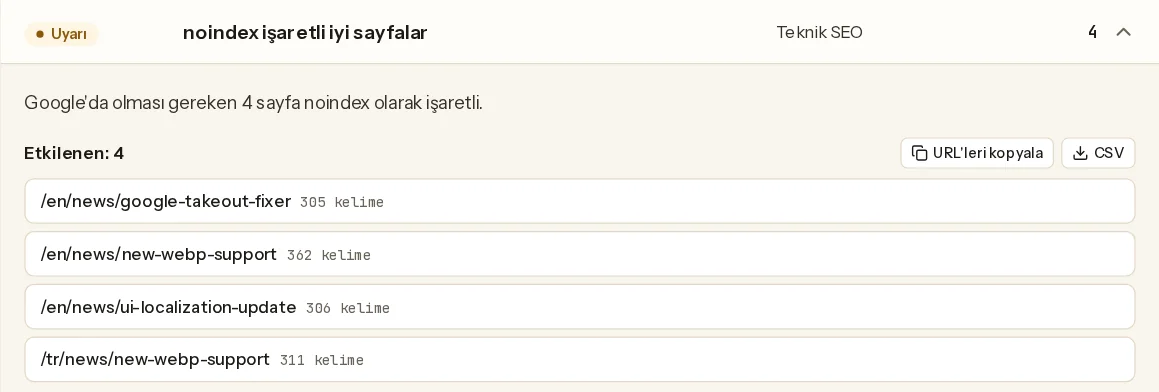
access.noindex_home: ana sayfadanoindex(ya da meta etiketindenone) varsa kalır.tech.noindex_pages: yazı olarak sınıflandırdığımız sayfaların %30'undan fazlası noindex taşıyorsa çıkar.tech.noindex_misused: Google'da olması gerekirken noindex olan sayfaları listeler. Bunlar ana sayfa ya da arşiv, arama, sayfalama, yardımcı sayfa veya güven sayfası olmayan, kendine ait en az 300 kelime metni bulunan sayfalardır.seo.robots_conflict: sayfada hem meta etiket hem başlık var ve yalnızca biri noindex diyorsa çıkar.structure.index_bloat: noindex olmayan yardımcı, arama ve sayfalama adreslerini, kendine ait metni yaklaşık 250 kelimenin altında kalan arşiv sayfalarını listeler. Adres kalıplarına ve taradığımız sayfalara dayanan bir tahmindir.
Taradığımız bir siteden gerçek örnek: her biri 305 ile 362 kelime arasında olan dört haber yazısı noindex işaretliydi.
Kuralların tamamı metodoloji sayfasında.
Kaldırdıktan sonra
Google tekrar taramadan hiçbir şey değişmez. Google'ın ifadesiyle meta etiketleri ve HTTP başlıklarını görmek için sayfayı taraması gerekiyor ve sayfanın önemine göre "it may take months for Googlebot to revisit a page", yani tekrar ziyaret aylar sürebilir (dizine eklemeyi engelleme). Önemli sayfalar için URL Denetimi'nde "Request indexing" kullan; Google dizine eklemenin bir iki hafta sürebileceğini söylüyor. Sayfaların site haritasında olduğundan (XML site haritası hataları) ve canonical'larının kendilerini gösterdiğinden (canonical etiketi sorunları) emin ol.
AdSense tarafında: reklam yerleşimi politikaları, Google'ın değerlendiremediği içerikte reklamı kapatabileceğini söylüyor ve örnek olarak robots.txt engelini ve şifreli içeriği sayıyor. Noindex orada geçmiyor. Pratik risk daha basit: yazılarının çoğunu gizleyen bir site olduğundan daha zayıf görünür. İnceleme sürecindeysen WordPress ve Blogger rehberleri bu platformlarda bakman gereken diğer ayarları anlatıyor.
Ücretsiz tarama, taranan sayfalardaki meta etiketleri ve başlıkları okur; sayfanın görünüşüyle çelişen her sayfayı listeler.
Sık sorulan sorular
Tek başına nofollow sayfayı gizler mi?
Hayır. nofollow, Google'a o sayfadaki linkleri takip etmemesini söyler. Sayfanın kendisini sonuçların dışında tutan yalnızca noindex (ya da none).
Noindex'i bir hafta önce kaldırdım, sayfa hâlâ yok. Ne yapayım?
URL Denetimi'nde "Test live URL" çalıştır. "Indexing allowed?" artık evet diyorsa dizine ekleme isteği gönder ve bekle; tarama zamanlaması Google'da. Hâlâ hayır diyorsa noindex hâlâ sunuluyor demektir, genellikle bir başlıktan ya da önbellekten.
Tarama bütçesi için noindex sayfaları robots.txt'den de engelleyeyim mi?
Noindex'in çalışmasını istiyorsan hayır. Google kuralı okumak için sayfayı çekmek zorunda. Engellemek, hiç taranmasını istemediğin adresler için mantıklı (sonsuz filtre kombinasyonları gibi); çıkarmaya çalıştığın sayfalar için değil.
Etiket sayfalarında noindex AdSense'e zarar verir mi?
AdSense'in yayımlanmış politikalarında böyle bir şey yok. Zayıf liste sayfalarını dizin dışında tutmak yazılarını gizlemez; yazıların kendisindeki noindex gizler.
Eskimiş ya da yanlış bir şey mi gördün? Bize yaz, düzeltelim.
Bu rehberi İngilizce oku →Kendi sitende kontrol et. Ücretsiz, kayıt yok.
Bunun için ücretsiz araçlar
Ücretsiz tarama
Kendi siteni kontrol et
Ücretsiz tarama: uygunluk puanı ve tüm sorunlar, genelde birkaç dakikada.